Alibaba slibuje levnější Qwen4-Max, nezávislé testy ale ukazují smíšený obraz
Alibaba představila Qwen4-Max, nový vlajkový model s 2,4 bilionu parametrů, z nichž při zpracování jednoho tokenu aktivuje jen 71 miliard. Firma tvrdí, že stojí výrazně méně než konkurence, a míří s ním na odbornou práci v průmyslu, vědě a financích. Informuje o tom web The Decoder. Všechny výsledky z vlastních testů Alibaby je zatím třeba brát jako tvrzení výrobce.
Co model dělá a jak je postavený
Qwen4-Max patří mezi jazykové modely typu mixture-of-experts (směs expertů). Jeho parametry, tedy naučené číselné váhy, jsou rozdělené do skupin, z nichž se pro každý token (zhruba slovo nebo jeho část) použije jen malý díl. Výpočet je proto levnější, než by odpovídalo celkové velikosti. Podle týmu Qwen model nativně zpracovává obrázky a má kontextové okno o velikosti milionu tokenů.
Novinkou je hybridní architektura, která se poprvé objevuje v řadě Qwen4. Tři vrstvy stlačí předchozí text do zhuštěného stavu a čtvrtá z něj vybere jen podstatné části. Model tak nemusí věnovat stejnou pozornost celému kontextu, což podle Alibaby výrazně snižuje výpočetní nároky u dlouhých vstupů. Mezi vrstvami dále vedou čtyři paralelní spojení s dynamickými branami, které mají stabilizovat tok informací. Embeddingová vrstva n-gramů o 328 miliardách parametrů dodává časté sekvence tokenů jako hotové stavební kameny. Trénink podle firmy probíhal stabilně a chybová funkce klesala bez náhlých skoků.
Cena a výsledky v testech
Úspory se podle Alibaby projevují v provozu. V jejím vlastním testu Work360, který zahrnuje úlohy ze 721 odborných oborů, spotřebuje Qwen4-Max zhruba o čtvrtinu až třetinu méně tokenů než předchozí model. V agentním testu Terminal-Bench 4.0 je spotřeba téměř poloviční. Průměrná cena úlohy ve Work360 klesla o 62 %, ze 4,43 na 1,67 dolaru, a skóre vzrostlo ze 47,74 na 52,69 bodu.
Externí hodnocení přinášejí smíšený obraz. V testu dlouhodobých agentních úloh Agents' Last Exam v1.1 získal model 46,7 bodu, tedy nejvíce ve srovnávané skupině. V Humanity's Last Exam zaostává za Opus 5.5 i modely GPT. Za těmi zůstává také v HealthBench Professional, kde však těsně předstihl Opus 5.5.
Nezávislé srovnání nabízí Artificial Analysis. Na jeho indexu inteligence získal Qwen4-Max při nejvyšším nastavení uvažování 43 bodů. To je o devět více než Qwen3.8-Max a o tři méně než Kimi K3.1 Pro, nejlepší čínský model se 46 body. Cena jedné úlohy indexu vychází na 3,27 dolaru, zatímco u předchůdce to bylo 10,02 dolaru a u Kimi K3.1 Pro 3,68 dolaru. Úspora plyne ze tří zdrojů: ceny tokenů jsou o 25 % nižší, zásahy v mezipaměti stojí o 70 % méně a model potřebuje menší počet tokenů, zhruba 105 000 výstupních na úlohu proti 171 000 u předchůdce.
Levnější je Hy4 od Tencentu s cenou 1,03 dolaru za úlohu, ale na indexu získal o osm bodů méně. V Terminal-Bench 4.0 dosáhl Qwen4-Max 48 %, kdežto Kimi K3.1 Pro 67 %. V testu FrontierCode 2.0 od firmy Cognition se s Kimi dělí o výsledek 26 %, zatímco Tencent Hy4 má 31 %.
Přes vlastní rozhraní API si Alibaba účtuje 1,50 dolaru za milion vstupních tokenů a 4,50 dolaru za milion výstupních. Zásah v mezipaměti stojí 0,075 dolaru.
Agenti, laboratoře a hry
Alibaba při uvedení modelu staví na samostatném zvládání dlouhých úloh. Aby uživatel neviděl výsledek až na konci, nabízí funkci „Live Delivery“ (Průběžné dodávání). Model brzy dodá použitelnou první verzi a rozpracovává ji v dalších průchodech, přičemž uživatel může kdykoli změnit směr. Související zásuvný modul Qwen-Live-Delivery-Plugin firma zveřejnila s otevřeným zdrojovým kódem.
Alibaba uvádí také nasazení u partnerů. Automobiloví partneři SANF a Pacific Union prý zkrátili ruční programování jednoho obrobku z přibližně 475 na 24 minut. Ve financích model využívá 90 nástrojů MCP ke stahování tržních dat a výsledky dodává jako ověřitelné soubory Excel a PowerPoint s dohledatelným původem čísel. S pomocí vlastního řešiče MindOpt snížil náklady na přidělování výpočetních úloh pro anotaci dat v průměru o 10,42 %. Při rozdělování úloh CPU v datacentrech našel optimální řešení více než čtrnáctkrát rychleji než srovnávací metoda.
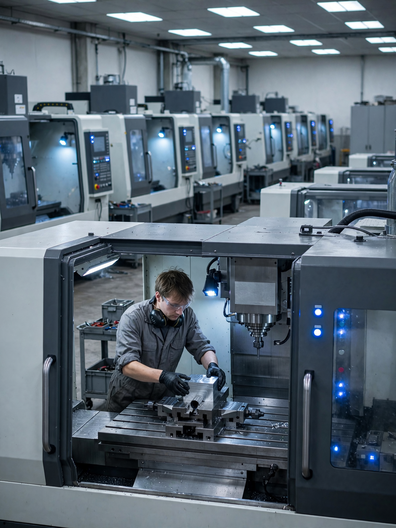
Ve spolupráci se systémem Mira od startupu Deep Principle model podle Alibaby 48 hodin autonomně navrhoval, syntetizoval a testoval nové chladivo pro výkonné čipy v datacentrech. Prohledal 2,7 milionu molekulárních kandidátů, řídil automatizovanou laboratoř a dokončil čtyři celé cykly návrhu, syntézy a měření. S platformou PharmMaster od pekingského startupu DP Technology optimalizoval 24 kandidátních molekul proti zánětlivé reakci spojené s Alzheimerovou chorobou. Finální kandidát se podle Alibaby váže na cílový protein zhruba 3,6krát lépe než známá výchozí látka z patentu. Experti DP Technology výsledek považují za dostatečně slibný pro další laboratorní testy.
Model má také z jediného textového zadání vytvořit hratelnou hru v enginech Unity, Unreal Engine a Godot. Ukázkovým projektem je „Meow of Magic“ (Mňouknutí magie), dobrodružství v Unreal Engine o kočce čarodějce. Model hru sám spouští a podle vizuální a interaktivní zpětné vazby ladí kameru, animace i osvětlení. Anthropic přitom nedávno zvolil opačný směr: po vlně neoficiálních klonů Halo a GTA: Vice City zakázal svému nástroji Claude Code existující hry napodobovat.
Bezpečnost a dostupnost
V testu Last Secure Code Bench vzrostl podíl kódu, který je funkční i bezpečný, z 22 na 31,8 %. U hodnocení bezpečnosti na všech třech úrovních testování se tento podíl téměř zdvojnásobil, z 8 na 14,7 %. Alibaba také zkoumala rizika CBRN (chemická, biologická, radiologická a jaderná). Interní hodnotitelé prošli úplné řetězce uvažování modelu a podle firmy nenašli schopnost, která by uživateli podstatně zvýšila možnosti. Nezávislé ověření těchto tvrzení zatím nemáme.
Qwen4-Max je dostupný v QwenCloud a v produktech QwenWork, Qoder a QwenStudio. Menší modely Qwen4 chce Alibaba později vydat s otevřeným zdrojovým kódem, váhy varianty Max však zveřejňovat nebude. Předchozí Qwen3.8-Max, který vyšel v srpnu, měl také 2,4 bilionu parametrů, ale 95 miliard aktivních na token.
Co z toho plyne
Pro české firmy a vývojáře je důležitější než pořadí v žebříčku cena za dokončenou úlohu. U agentů, kteří spotřebují stovky tisíc tokenů na jeden úkol, rozhoduje o nákladech právě jejich počet. Otevřené zůstává, zda se úspory potvrdí mimo Alibabou vybrané testy, jak se model chová v evropských jazycích a jak bude vypadat nabídka menších modelů s otevřenými váhami. Při nasazení v EU bude navíc záležet na tom, jak se k univerzálním modelům a jejich poskytovatelům postaví regulace podle nařízení o umělé inteligenci (AI Act).